黄仁勋卸任英伟达 CEO 背后:三十三年算力帝国的四次生死转向与组织实验
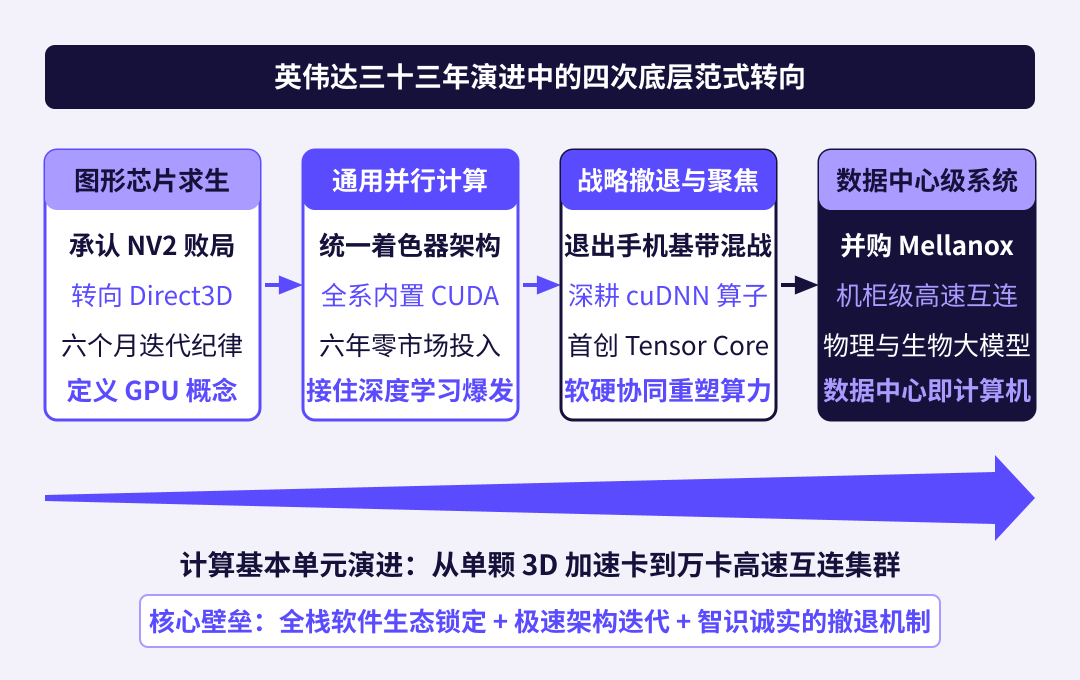
当一位执掌同一家芯片公司长达三十三年的创始人交出首席执行官帅印,他留下的远不止数万亿美元的市值记录。翻开英伟达自 1993 年以来的技术与商业档案,真正决定这家公司命运的并非顺风期的规模扩张,而是四次在濒临破产或旧赛道见顶时的主动战略撤退与底层重构。
science
编者注(2026 年 11 月 16 日): 原文保留了发表时对交接细节的说明。根据英伟达 11 月 12 日发布的官方公告,黄仁勋辞去总裁、首席执行官及董事职务并立即生效,Colette Kress 出任临时 CEO,兼任 CFO。
2026 年 11 月,硅谷传来重磅人事变动消息:自 1993 年 4 月共同创立英伟达(NVIDIA)以来一直担任总裁兼首席执行官的黄仁勋(Jensen Huang),宣布辞去 CEO 等管理职务(注:截至发稿,关于职务交接的具体生效时间表、董事会席位安排及继任架构细节,仍以英伟达向美国证券交易委员会 SEC 递交的正式监管文件为准)。在半导体这样一个平均每隔十年就会经历一次技术范式洗牌、巨头折戟率极高的残酷行业里,一位创始人连续三十三年站在产品定义与工程架构的第一线,本身就是一个罕见的商业样本。本文以这一历史性节点为切入口,依据公开技术文献与历史档案,复盘黄仁勋在英伟达演进历程中的四次关键决策,以及他为这家庞然大物设计的独特组织架构。
1. 濒死时刻的智识诚实:从 NV1 败局到六个月节奏的工程纪律
英伟达在成为算力巨头之前,首先学会的是如何在架构路线押错时活下来。1993 年初,曾在 AMD 从事微处理器设计、并在巨积(LSI Logic)担任核心业务部门主管的黄仁勋,与来自太阳微系统(Sun Microsystems)的两位工程师克里斯·马拉科夫斯基(Chris Malachowsky)和柯蒂斯·普里姆(Curtis Priem),在圣何塞贝里埃萨路(Berryessa Road)的一家丹尼餐厅(Denny’s)敲定了创业计划 [1]。当时 PC 3D 图形加速芯片市场正处于混战前夜,巅峰时期全球有数十家初创公司同场搏杀。
1995 年,英伟达推出了第一代产品 NV1。在当时的技术条件下,三位创始人做了一个看似巧妙却偏离主流的架构决定:没有采用业界通用的多边形三角形网格渲染,而是选择了二次曲面纹理映射(Quadratic Texture Mapping, QTM),并试图在一颗芯片上同时集成 2D/3D 图形、声卡以及世嘉土星(Sega Saturn)游戏手柄接口。仅几个月后,微软随 Windows 95 发布了 Direct3D 图形接口标准,明确将基于多边形三角形的渲染流水线定为行业唯一通用准则。与行业标准背道而驰的 NV1 迅速沦为商业败局,退货积压几乎抽干了公司的现金流。
真正的生死考验发生在 1996 年。当时世嘉(Sega)与英伟达签署了一份价值 700 万美元的合同,委托其基于二次曲面技术为下一代主机 Dreamcast 开发 NV2 芯片。研发推进到中途,黄仁勋与工程团队意识到:二次曲面在数学和硬件扩展性上是一条死胡同。如果硬着头皮按合同交货,英伟达虽然能拿到尾款,但造出来的将是一颗没有未来的废片;如果立刻停工违约,公司账上的现金撑不过一个月。
黄仁勋做出了创业生涯中第一次展示其“智识诚实”(Intellectual Honesty)的决定。他亲自飞往见世嘉美国公司总裁入交昭一郎(Shoichiro Irimajiri),当面坦白 NV2 的技术路线走错了,建议世嘉立即更换供应商以免耽误主机上市;同时,他提出了一个近乎苛刻的请求——希望世嘉依然支付剩余的 500 万美元(后转为对英伟达的股权投资),因为没有这笔钱英伟达就会立刻破产,世嘉前期的投入也将血本无归 [1]。入交昭一郎最终答应了这一请求,这笔钱给了英伟达整整六个月的喘息窗口。
拿着仅剩的救命钱,黄仁勋在内部推行了三项近乎严酷的改革:
-
彻底推倒重来与裁员过半:果断砍掉所有专有图形接口探索,公司人数从一百余人缩减至四十人左右,全员转向全面兼容微软 Direct3D 的三角形多边形流水线。
-
重金购入硬件仿真器:为了确保下一颗芯片一次流片成功,黄仁勋动用公司仅存的大部分流动资金,买下昂贵的 IKOS 硬件仿真加速系统,在芯片尚未流片前就开始同步编写并调试驱动程序。
-
打破行业常规的“六个月节奏”:当时半导体行业的标准开发周期是 18 至 24 个月,而黄仁勋将英伟达的架构迭代周期强行压缩到 6 个月,组建三个研发团队像接力赛一样交错推进。
1997 年 8 月,第三代芯片 RIVA 128(NV3)面世,四个月内售出超百万颗,将英伟达从破产边缘拉了回来。仅仅两年后的 1999 年 8 月,英伟达发布 GeForce 256,首次在单颗芯片上集成了硬件几何变换与光照单元(Transform and Lighting, T&L),并正式在行业内定义了“图形处理器”(GPU)这一概念 [2]。那场濒死危机留下的“距倒闭永远只有三十天”(Thirty days from going out of business)的危机意识,自此写进了英伟达的工程基因。
2. 为“零十亿美元市场”买单:CUDA 豪赌与架构泛化
如果说 RIVA 128 救了英伟达的命,那么 2006 年推出的 CUDA(Compute Unified Device Architecture)则彻底改写了英伟达的物种属性。
21 世纪初,斯坦福大学帕特·汉拉汉(Pat Hanrahan)与比尔·达利(Bill Dally)实验室的博士生伊恩·巴克(Ian Buck)等人敏锐地发现,GPU 内部用于计算像素颜色的并行着色器,其实可以被“欺骗”用来做通用的矩阵和向量运算。2004 年,伊恩·巴克团队在计算机图形学顶会 SIGGRAPH 上发表了奠基性论文 Brook for GPUs: Stream Computing on Graphics Hardware [3],首次系统展示了如何用 C 语言的流式扩展在图形硬件上运行通用科学计算(GPGPU)。
黄仁勋第一时间捕捉到了这篇学术论文背后的工程信号。他随即把伊恩·巴克招入麾下,并与当时的英伟达首席科学家大卫·柯克(David Kirk)达成共识:不能让科研人员继续用伪装成纹理贴图的黑客手段来写代码,英伟达必须从芯片底层硬件架构上抹平图形与计算的边界。
2006 年 11 月,伴随代号为 G80 的 GeForce 8800 GTX 显卡发布,英伟达正式推出了统一着色器架构与 CUDA 编程模型 [4]。为了让每一颗游戏显卡都能直接运行标准 C 语言编写的并行计算程序,黄仁勋决定在每一颗出货的 GPU 晶圆上额外增加专用的计算控制逻辑与片上共享内存。
在当时的华尔街分析师眼中,这是一笔极其糟糕的财务账:
-
硬件成本全员分摊:哪怕买显卡的只是一个普通的《魔兽世界》玩家,他手里的芯片也包含了为科学计算准备的冗余晶体管,这直接推高了每一颗消费级芯片的裸片面积(Die size)、功耗与制造成本。
-
长达六年的收入荒漠:从 2006 年到 2012 年,英伟达每年投入数亿美元维护和升级 CUDA 软件栈,但全球真正购买专业计算卡(Tesla 系列)的客户仅限于少数气象局、石油勘探机构和大学物理系。在黄仁勋后来常提的“零十亿美元市场”(Zero-billion dollar market)阶段,公司市值长期在百亿美元以下徘徊,甚至在 2008 年因封装缺陷风波与移动芯片冲击而股价腰斩。
但黄仁勋坚持了一条极少有职业经理人敢执行的策略:把 CUDA 塞进每一张卖给游戏玩家的普通显卡里。到 2012 年前夕,全球大学实验室、研究生宿舍和个人电脑里,已经静默躺着上亿颗支持 CUDA 的 GPU。
转折点在 2012 年秋天准时到来。多伦多大学的亚历克斯·克里泽夫斯基(Alex Krizhevsky)、伊利亚·苏茨克维(Ilya Sutskever)与杰弗里·辛顿(Geoffrey Hinton)在训练深度卷积神经网络 AlexNet 时,没有去申请昂贵的超算中心机时,而是直接用卧室里的两张消费级 GeForce GTX 580(3GB 显存)显卡,通过跨 GPU 的 CUDA 编程跑完了 ImageNet 数据集的训练,将图像识别错误率一举降低了十个百分点以上 [5]。因为 CUDA 早已铺满了全球每一个计算机系实验室的桌面,深度学习从诞生的第一天起,就原生生长在了英伟达的软件指令集之上。
3. 战略撤退与计算单元重定义:从放弃手机芯片到收购 Mellanox
复盘黄仁勋的决策史,一个常被外界忽略的侧面是:他做减法与主动撤退的果断程度,丝毫不亚于做加法。
2010 年前后,智能手机浪潮席卷全球,英伟达也曾试图凭借 Tegra 系列移动处理器切入主流手机市场,甚至在 2011 年斥资 3.67 亿美元收购了英国基带芯片公司 Icera。然而短短三年后,高通凭借基带与射频集成优势统治了安卓阵营,苹果则全面转向自研 A 系列芯片,手机 SoC 迅速演变为一场拼规模、拼低毛利的血海战争。
2014 至 2015 年间,黄仁勋做出了极为冷静的战略撤退:全面关停并剥离 Icera 手机基带业务,彻底退出主流智能手机处理器市场。他没有让工程团队在别人制定规则的存量战场里流血,而是将 Tegra 积攒的低功耗嵌入式架构能力,悉数转移到了当时尚处于早期的自动驾驶计算平台(NVIDIA DRIVE)、边缘机器人模块(Jetson)以及任天堂 Switch 游戏机芯片上。
与此同时,在看清 AlexNet 揭示的深度学习缩放趋势后,英伟达开启了从“芯片供应商”向“全栈计算系统公司”的剧烈进化:
-
软硬件协同定义算子:2014 年推出深度神经网络加速库 cuDNN,工程师直接钻进各大 AI 实验室的代码库,把卷积、池化和注意力机制底层算子优化到极致;2016 年推出首台一体化深度学习超算服务器 DGX-1,由黄仁勋亲自送到刚刚成立不久的 OpenAI 办公室。
-
专用矩阵核心重构芯片面积:在 2017 年发布的 Volta(V100)架构中,英伟达首次引入专门用于混合精度矩阵乘加运算的张量核心(Tensor Cores)[6];此后经由 Ampere(A100)、引入 FP8 Transformer 引擎的 Hopper(H100),一路演进至 Blackwell 与 Rubin 架构,硬件微架构的演进节奏完全与大模型参数规模的膨胀咬合在一起。
这期间最具远见的一笔资本运作,是 2019 年 3 月宣布、2020 年 4 月正式完成的以 69 亿美元 收购以色列高速网络互连巨头 Mellanox Technologies(迈络思)[7]。在收购达成时,这是英伟达历史上金额最大的一笔并购。
概念 | 数据中心即计算机(Data Center as the Unit of Computing)
在大模型分布式训练与推理时代,单颗芯片的峰值算力不再决定系统上限。计算的基本单元已从单张板卡扩展为整座数据中心,机柜内外的超高速互连(NVLink 与 InfiniBand)与算力调度软件共同决定了万卡集群的有效吞吐率。
当时许多市场观察者不明白一家显卡公司为什么要重金买下一家做 InfiniBand(无限带宽技术)交换机和网卡的通信企业。黄仁勋给出的逻辑改写了现代算力基础设施的公式:当模型参数跨过百亿、千亿门槛,单张 GPU 甚至单台八卡服务器都装不下一个完整模型,数据中心本身成了新的计算机。如果芯片之间的通信带宽(I/O)跟不上,花几亿美元买来的数万张顶级 GPU 就会有一半以上的时间停下来干等梯度同步。通过吞并 Mellanox 并将其 RDMA(远程直接内存访问)技术与自家的 NVLink、NVSwitch 深度融合,英伟达得以推出像 GB200 NVL72 这样将 72 颗 GPU 通过铜缆高速背板锁死成“单颗巨型芯片”的机柜级产品,筑起了竞争对手仅靠单点流片无法逾越的系统墙。
4. 对抗大公司衰老的组织实验:六十个直接下属与“T5T”邮件
在探讨技术路线之外,管理学界与科技产业更关心另一个问题:为什么英特尔、IBM 等老牌巨头在规模膨胀后纷纷陷入部门墙高筑、创新迟滞的“大公司衰老症”,而英伟达在市值突破数万亿美元后,依然能保持近似初创公司的敏捷度?
答案藏在黄仁勋亲手设计并维持了三十多年的反常规组织拓扑结构里 [8]。
首先是极度扁平的汇报层级。在绝大多数跨国科技企业里,CEO 直接管理的下属(Direct reports)通常遵循管理学教科书的建议,控制在 6 到 10 人之间,每个人分管一个庞大的事业部(Business Unit, BU)。而黄仁勋的直接汇报对象长期保持在 50 到 60 人。他的逻辑很直接:层级越少,信息在传递过程中的失真(熵增)就越小;想要维持如此宽的管理幅度,前提是直接向 CEO 汇报的高管必须具备极高的专业成熟度,不需要花时间做情绪安抚或向上管理的表面文章。
其次是著名的 “Top-5 Things”(T5T)全员邮件机制。在复杂的科层制组织里,底层工程师发现的技术盲区或前沿信号,往往要经过经理、总监、副总裁的层层过滤与美化,才能变成一份排版精美的 PPT 摆上最高决策层的桌面——此时信号早已滞后了半年。在英伟达,从基层研发人员到高管,都会定期发送极其简短的纯文本邮件,列出自己手头正在推进或观察到的“最重要的五件事”。黄仁勋每天清晨与深夜阅读上百封来自一线的 T5T 邮件,这相当于给公司的中枢神经系统装上了直达末梢毛细血管的传感器。当年早期科研人员用 GeForce 显卡跑深度学习、用机器人套件做仿真等微弱信号,正是通过这条无中介的通路直接进入了最高资源调配视野。
第三是废除独立事业部藩篱,奉行“任务即老板”(Mission is the Boss)。英伟达内部不按产品线切分独立核算盈亏(P&L)的诸侯国。无论是芯片架构、系统硬件还是底层软件团队,全部作为共享的能力底座存在;每当公司锁定一个新方向——无论是早期的自动驾驶、工业数字孪生平台 Omniverse,还是面向生命科学虚拟细胞与蛋白质设计的 BioNeMo 平台 [9]——资源都会按照“具体任务”跨部门瞬间拉通,任务结束或证伪后人员迅速回流重组。
一家科技公司的衰老,从来不是因为工程师停止了思考,而是因为科层制的部门墙与保卫存量利润的本能,截断了一线微弱信号抵达资源调配中枢的神经突触。
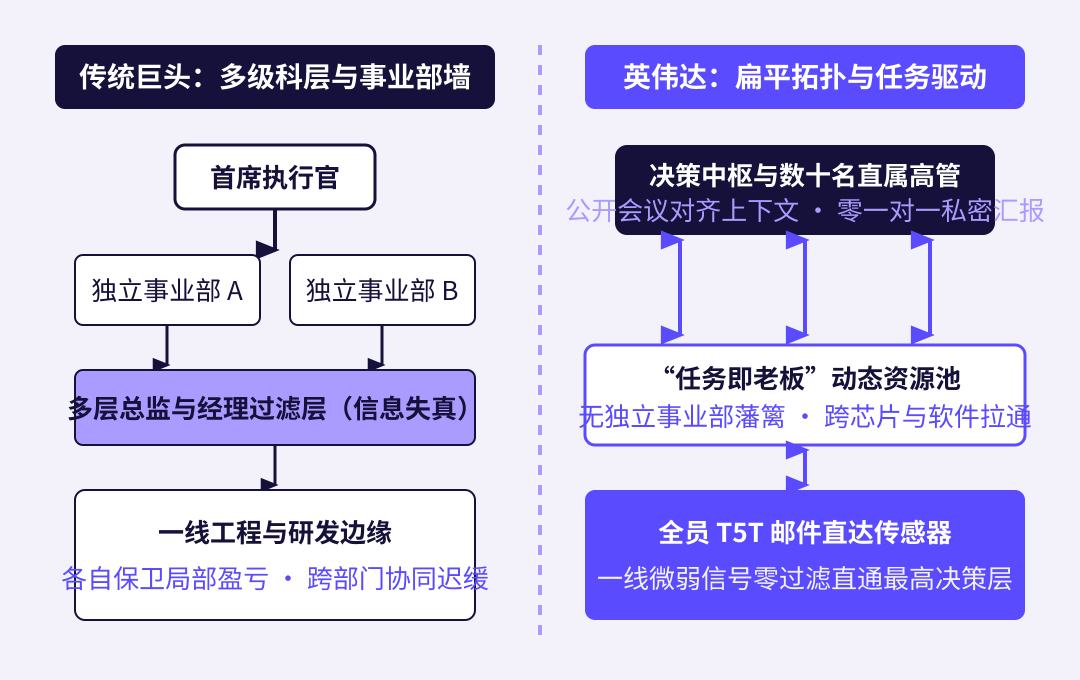
此外,黄仁勋几乎从不与下属进行传统的一对一(1-on-1)私密述职,战略讨论与技术复盘全部在几十人的公开会议上进行。这种做法背后的工程考量是:让所有核心节点在同一秒钟接收到完全相同的上下文(Context),既消除了办公室政治的信息差,也迫使任何一项错误决策在公开审视下无处藏身。
5. 后黄仁勋时代的开放问题:当全栈护城河遇上推理经济学与组织传承
黄仁勋的转身离场,标志着硅谷由第一代硬核芯片创始人亲自带队冲锋的黄金时代画上了句号。站在 2026 年末的产业节点往前看,卸任后的英伟达虽然坐拥空前深厚的软硬件护城河,但继任管理层面前依然摆着三个尚未完全解答的结构性难题。
第一,当大模型产业重心从“不计成本的预训练”转向“精打细算的规模化推理”,全栈系统的溢价空间还能维持多久?在预训练阶段,模型架构日新月异,客户为了抢占时间窗口必须购买通用性最强、互联带宽最高的旗舰 GPU 集群。然而随着推理流量占比超过训练,谷歌(TPU)、亚马逊(Trainium/Inferentia)、微软与 Meta 等超大规模云厂商(Hyperscalers)正在全力推进自研定制化 ASIC 芯片以压降单 Token 推理成本。失去了创始人光环加持的英伟达,能否仅凭 NVLink 机柜级集成能力与 CUDA/NIM 软件栈,继续守住高达七成以上的硬件毛利率?
第二,高度依赖创始人权威与技术直觉的“60 人扁平网络”,在交棒给职业经理人团队后能否避免向传统科层制退化?黄仁勋的扁平化管理、T5T 邮件直通车与不设独立事业部制度,之所以能高效运转三十三年,很大程度上是因为他本人同时具备联合创始人的绝对权威与深不可测的工程架构判断力——他听得懂底层晶圆封装的参数,也看得懂注意力机制的算子瓶颈。正如苹果在乔布斯之后不可避免地走向精细化供应链运营一样,当英伟达进入后创始人时代,如何防止组织为了规避风险而重新长出层层审批的“中间管理层”与各自为战的部门墙,将是对其组织遗产最大的考验。
第三,数字生物学与物理 AI(Physical AI)能否接棒大语言模型,成为下一个十年的超线性增长引擎?在黄仁勋任期的最后几年,他反复将赌注押在两个尚未完全爆发的前沿领域:一是赋予具身智能机器人物理世界规律理解能力的 Omniverse 与 Cosmos 世界模型;二是以 BioNeMo 为底座、试图将分子生成、蛋白质折叠与虚拟细胞扰动计算化的一站式生命科学平台。这两个领域面对的都不再是互联网上现成的文本语料,而是昂贵、嘈杂且受制于物理与生理节律的真实世界实验数据。当计算精度必须与湿实验验证和物理机械控制正面碰撞时,英伟达播下的这两颗种子能否长成下一片森林,将是检验其战略遗产成色的最终试金石。
要点
-
四次关键战略抉择:回顾英伟达三十三年历史,其崛起源于 1996 年承认 NV2 路线错误并全面转向 Direct3D 与六个月迭代周期、2006 年顶住长达六年的财务压力将 CUDA 塞进每一张消费级显卡、2014 年果断退出低毛利智能手机芯片混战,以及 2019 年斥资 69 亿美元收购 Mellanox 将计算单元从单颗芯片重定义为整座数据中心。
-
对抗衰老的组织工程:黄仁勋通过维持 50 至 60 名直接下属的极度扁平架构、全员直达的“Top-5 Things”邮件传感器以及废除独立事业部盈亏壁垒的“任务即老板”机制,最大化降低了万亿级企业的内部信息熵增与科层迟滞。
-
后创始人时代的三大考验:继任团队必须正面应对云厂商自研推理 ASIC 对高毛利通用 GPU 的侵蚀、失去创始人技术权威后扁平化组织如何避免退化回官僚科层制,以及物理 AI 与数字生物学(BioNeMo)能否在跨越真实物理验证瓶颈后成为新增长极。
参考文献与信源链接
-
Witt S. The Thinking Machine: Jensen Huang, Nvidia, and the World’s Most Coveted Microchip [M]. New York: Viking / Penguin Random House, 2025.
-
NVIDIA Corporation. Corporate Timeline and Form 10-K Annual Reports (1999–2026) [R]. Santa Clara: NVIDIA Investor Relations, 2026.
-
Buck I, Foley T, Horn D, et al. Brook for GPUs: stream computing on graphics hardware [J]. ACM Transactions on Graphics (SIGGRAPH), 2004, 23(3): 777-786.
-
Lindholm E, Nickolls J, Oberman S, et al. NVIDIA Tesla: A unified graphics and computing architecture [J]. IEEE Micro, 2008, 28(2): 39-55.
-
Krizhevsky A, Sutskever I, Hinton G E. ImageNet classification with deep convolutional neural networks [C]//Advances in Neural Information Processing Systems (NeurIPS), 2012, 25: 1097-1105.
-
Choquette J, Giroux O, Foley D. Volta: Performance and programmability [J]. IEEE Micro, 2018, 38(2): 42-52.
-
NVIDIA Corporation. NVIDIA Completes Acquisition of Mellanox Technologies, Creating Major Force Driving Next-Gen Data Centers [EB/OL]. NVIDIA Press Release, 2020-04-27.
-
Stanford Graduate School of Business. Jensen Huang: View From The Top & Organizational Design Discussions [EB/OL]. Stanford GSB Lecture Series, 2024.
-
NVIDIA Corporation. NVIDIA BioNeMo Framework for Digital Biology and Generative AI in Drug Discovery [EB/OL]. NVIDIA Developer Technical Overview, 2024–2026.